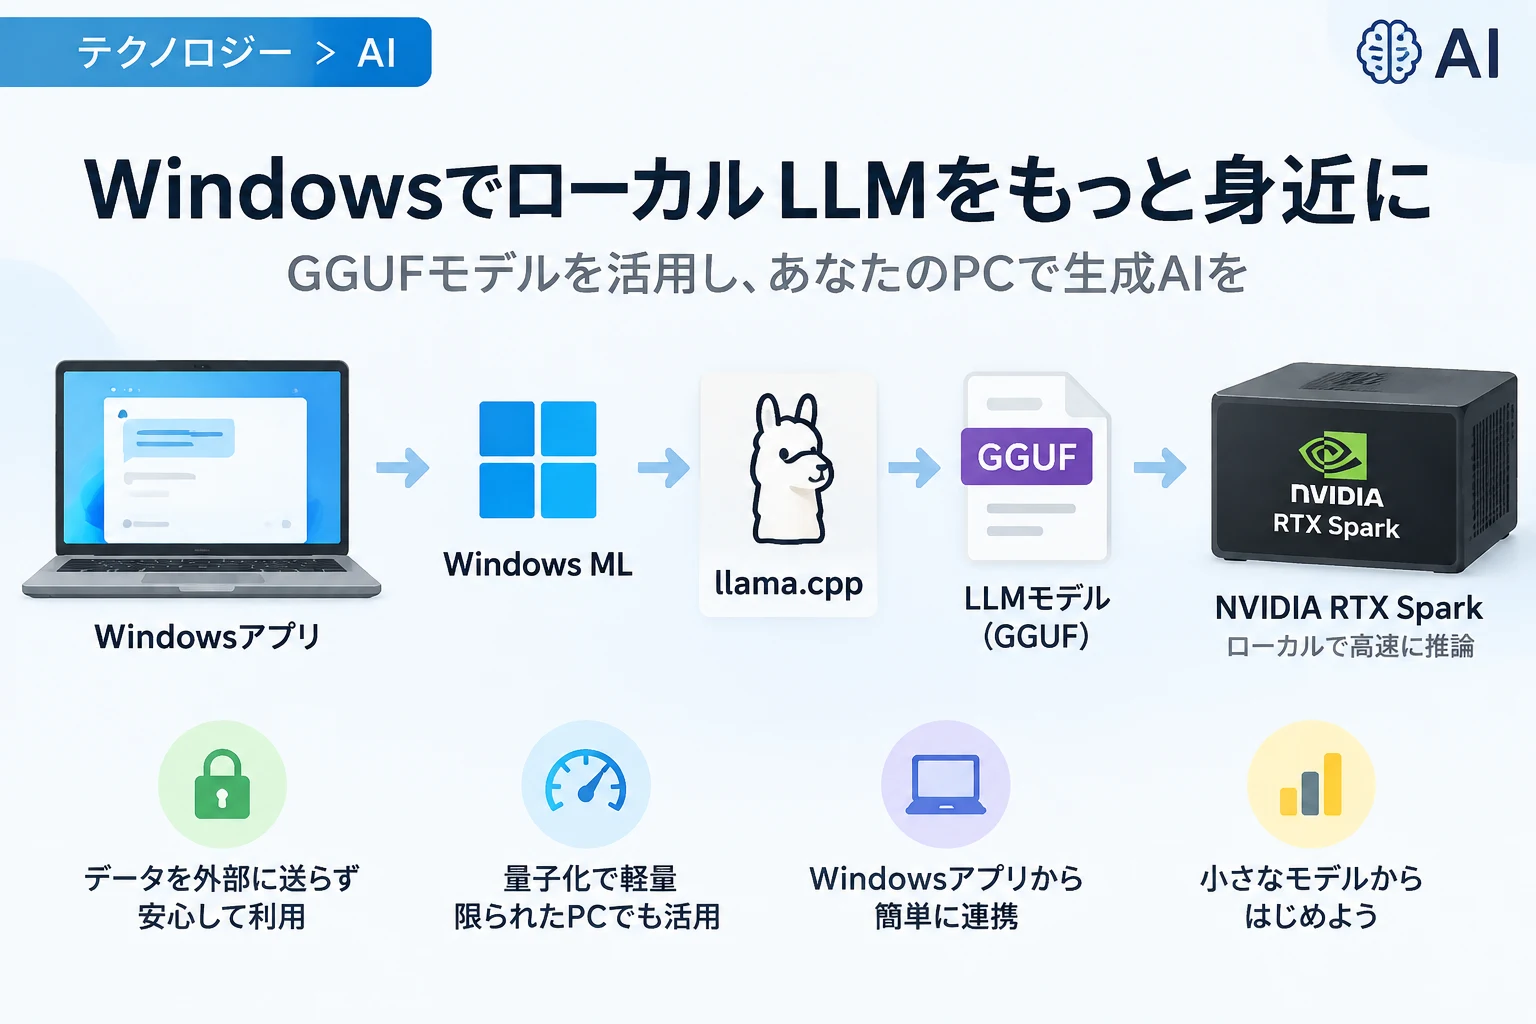
ローカル環境で生成AIを動かす際に選択肢となるのが、軽量な推論エンジン「llama.cpp」と、さまざまなLLMで使われるモデル形式「GGUF」です。
Windows MLがllama.cppに対応したことで、WindowsアプリからGGUFモデルを利用するための道筋が広がり、対応ハードウェアの性能を生かした推論にも期待が集まります。
Windows MLとllama.cppの連携で何が変わるのか
アプリと推論エンジンをつなぐWindows ML
Windows MLは、Windows上でAIモデルを実行するための仕組みで、アプリ開発者が推論処理を組み込む際の窓口として利用されます。
今回のポイントは、これまで独自に用意する必要があった実行環境の選択肢に、llama.cppを利用する道が加わることです。
ただし、Windows MLがllama.cppそのものを置き換えるわけではなく、モデルの読み込みや推論を担うエンジンと、アプリ側の呼び出しを支える仕組みを組み合わせて利用します。
GGUFモデルを使いやすくする理由
GGUFは、モデル本体や推論に必要な情報をまとめて扱えるファイル形式で、llama.cppを使ったローカル推論で広く利用されています。
モデルの量子化にも対応しており、重みの精度を調整してファイルサイズやメモリー使用量を抑えられるため、限られたメモリーのPCでも選択肢を広げやすい点が特徴です。
Windows ML経由で利用しやすくなれば、アプリごとに異なる実行方法を覚えたり、推論エンジンとの接続部分を個別に作り込んだりする負担を減らせる可能性があります。
| 要素 | 役割 | 利用者にとっての利点 |
|---|---|---|
| Windows ML | WindowsアプリからAI推論を利用するための仕組み | アプリへのAI機能の組み込みを簡素化しやすい |
| llama.cpp | LLMをローカルで動かす推論エンジン | 対応モデルや実行環境の選択肢が広い |
| GGUF | モデルを保存・配布するファイル形式 | 量子化モデルを含め、用途に応じて選びやすい |
NVIDIA RTX Sparkで期待されるローカルAI活用
NVIDIA RTX SparkのようなAI処理を意識した機器では、クラウドにモデルを送らず、手元の環境で文章生成や要約を行う使い方が注目されます。
推論をローカルで完結できれば、通信環境に左右されにくくなり、機密性の高いデータを外部サービスへ送信せずに扱える場合があります。
また、クラウドの従量課金を気にせず試せることも利点ですが、電力やハードウェアの費用、モデルの管理は利用者側で考える必要があります。
GPUを使えば必ず高速になるわけではない
llama.cppはCPUだけでなく、対応するGPUやバックエンドを使った推論にも対応していますが、実際の速度はモデル、量子化方式、メモリー容量、ドライバーなどで変わります。
Windows ML経由でGPUを活用する場合も、使用するWindows MLやllama.cppのバージョン、アプリの実装、デバイス側の対応状況を確認することが重要です。
「対応」と発表されたことだけで、すべてのGGUFモデルやすべてのGPUがそのまま利用できるとは限りません。
導入前に確認したいポイント
モデルのサイズとメモリー容量
LLMはモデルの規模が大きいほど高性能になりやすい一方で、モデル本体や推論時の作業領域に多くのメモリーを必要とします。
量子化モデルは容量を抑える手段になりますが、圧縮率を高めるほど回答品質に影響する場合があるため、用途に合わせて選ぶ必要があります。
まず小さめのモデルで動作と速度を確かめ、必要な品質や応答時間に合わせてモデルを変更する方法が現実的です。
対応状況とセキュリティ
実際に利用する際は、Windows MLの提供状況、llama.cpp連携を含む関連コンポーネントの要件、アプリが対応するモデル形式を確認してください。
なお、NVIDIA RTX Sparkという機器のOSや構成によっては、Windows MLを直接利用できない可能性があるため、Windows対応PCで使う場合と区別して確認することが大切です。
ローカル推論はデータを外部へ送らずに済む利点がありますが、モデルファイルの入手元やライセンス、アプリがログを保存するかどうかは別途確認しましょう。
開発者にとってのメリット
アプリ開発者にとっては、推論エンジンとの接続を共通化しやすくなることで、モデルの導入や対応環境の拡張にかかる作業を抑えられる可能性があります。
一方で、利用者のPCごとに異なるGPUやドライバー環境を考慮し、起動時のモデル選択やメモリー不足への対処を実装する必要は残ります。
したがって、Windows ML対応はローカルAIアプリ開発を容易にする一歩ですが、アプリの互換性や使い勝手が自動的に保証されるものではありません。
まとめ
Windows MLとllama.cppの連携は、WindowsアプリからGGUFモデルを扱うための選択肢を広げ、ローカルAIの導入を進めやすくする動きです。
NVIDIA RTX SparkのようなAI向け機器での活用にも期待できますが、実際の利用可否や性能はOS、ハードウェア、モデル、ソフトウェアの対応状況によって異なります。
まずは対応環境とモデルの要件を確認し、小さなGGUFモデルで動作を試すことが、導入を成功させる近道です。