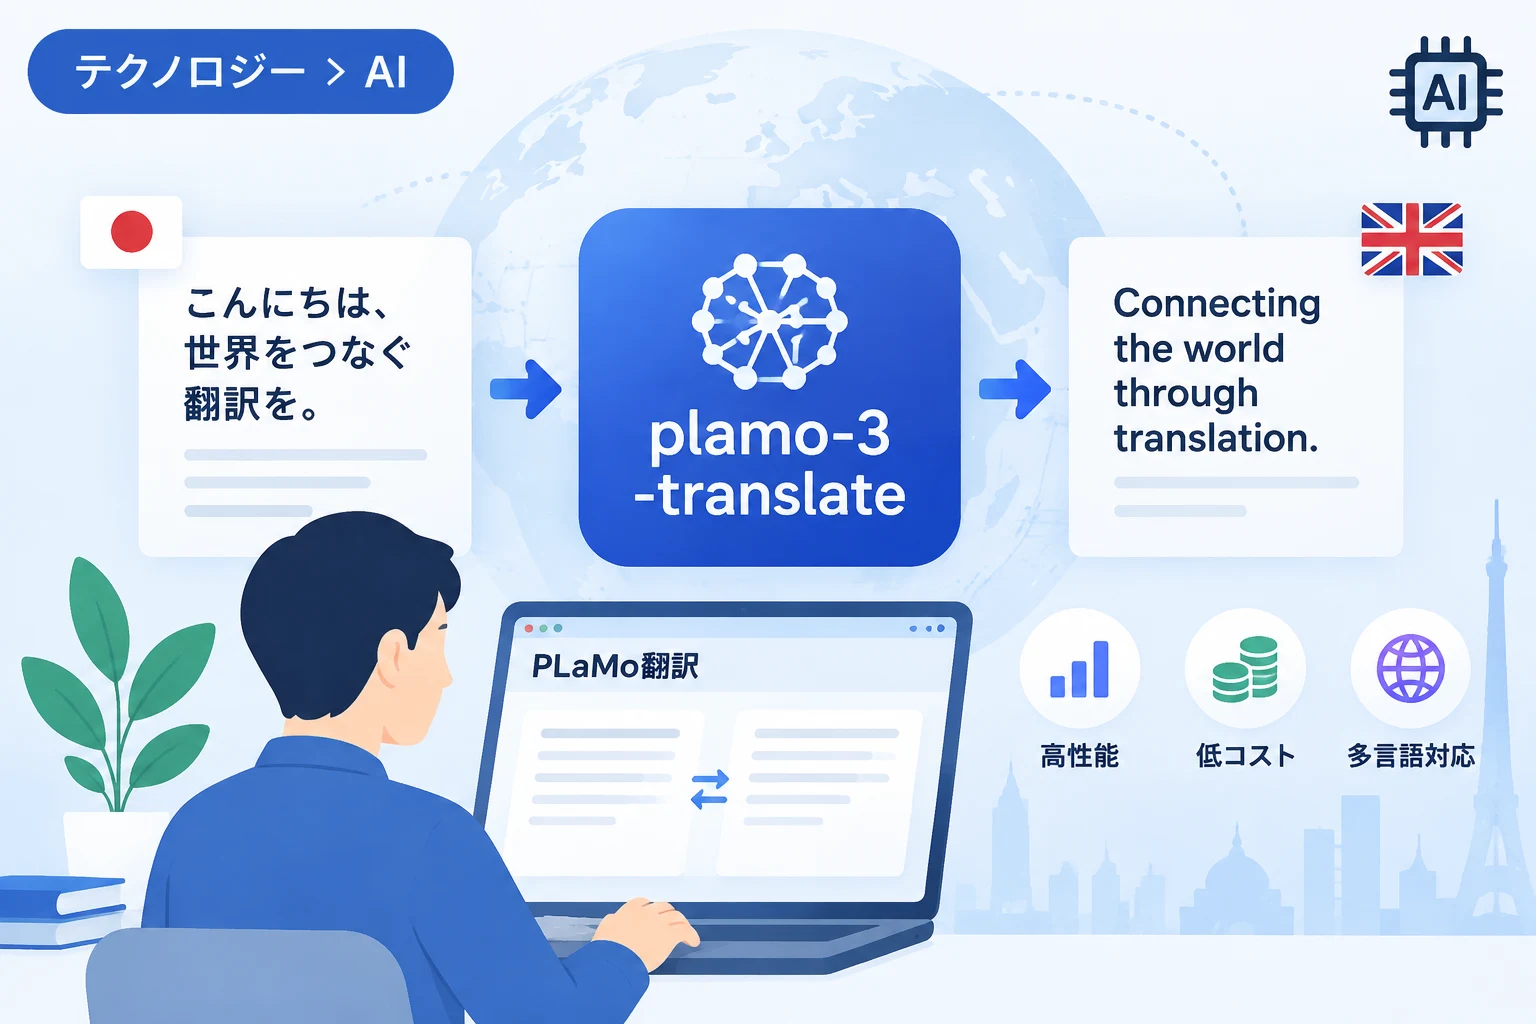
Preferred Networks(PFN)は2026年10月7日、翻訳に特化した大規模言語モデル「plamo-3-translate」を発表しました。
同社の翻訳サービス「PLaMo翻訳」にも同日から導入されており、日英・英日翻訳の性能向上や、多言語翻訳への対応強化が期待されます。
PFNの評価では、最大規模の31Bモデルが複数の比較対象を上回り、コストも抑えられるとしています。
翻訳に特化した新モデル「plamo-3-translate」
「plamo-3-translate」は、PFNが2025年5月に発表した「plamo-2-translate」の後継にあたるモデルです。
一般的な文章生成を幅広く行うモデルとは異なり、文章の意味や文脈を保ちながら別の言語へ変換する、翻訳タスクに焦点を当てて開発されています。
PFNは新モデルを自社の翻訳サービス「PLaMo翻訳」に導入しました。
同サービスにはWebブラウザー拡張機能やデスクトップアプリも用意されており、Webブラウザー以外の環境からも利用できます。
NICTとの共同研究で得られたモデルを基盤に採用
モデルの基盤には、PFNと国立研究開発法人情報通信研究機構(NICT)の共同研究から得られた事前学習モデル「PLaMo 3 NICT」が使われています。
PFNによると、前世代と比べて学習トークン量とデータ合成に使う計算量を数百倍に増やしました。
これにより、翻訳文で意味を過度に言い換えることや、原文にない情報を加えること、必要な情報が抜け落ちることなどの改善を図っています。
多言語の翻訳能力も強化したとされますが、公開資料で示された具体的な比較結果は、主に日英・英日翻訳に関するものです。
31Bモデルは日英・英日翻訳で高い評価
「plamo-3-translate」には、最大で310億パラメーターの31Bモデルが用意されています。
パラメーター数はモデルの規模を示す指標の一つですが、数が大きければ必ず翻訳品質が高くなるとは限りません。
PFNの評価では、31Bモデルは日英・英日翻訳で、比較対象とした翻訳サービスやLLMのAPIのほぼすべてを上回りました。
この結果は同社の評価に基づくものであり、対象となる文章や評価方法が変われば、モデル間の順位や差も異なる可能性があります。
| モデル・項目 | 公表された内容 |
|---|---|
| plamo-3-translate 31B | 日英・英日翻訳で比較対象のほぼすべてを上回ったとPFNが評価 |
| plamo-3-translate 8B | 社内ベンチマークのPFTB、SaaSでTranslateGemma 27Bを上回ったとPFNが発表 |
| コスト | 31Bモデルは、比較対象に対しておおむね30分の1前後とする試算 |
| モデル公開 | モデルの重みはHugging Faceで公開予定 |
8Bモデルは27Bの翻訳モデルを上回るスコア
31Bより小さい「plamo-3-translate 8B」も提供されます。
PFNの社内ベンチマークであるPFTBとSaaSでは、8BモデルがGoogleの翻訳特化モデル「TranslateGemma 27B」を日英・英日翻訳で上回るスコアを記録したと発表されています。
8Bモデルはパラメーター数が27Bモデルの3分の1未満であり、少ない規模でも高い翻訳性能を目指した設計が特徴です。
ただし、この比較結果はPFNが実施した特定の評価におけるもので、すべての文章や利用条件で同じ結果になることを示すものではありません。
コストを抑える仕組みと試算の注意点
PFNは31Bモデルについて、比較対象よりもコストをおおむね30分の1前後に抑えられると試算しています。
一方で、PLaMo翻訳のAPIは現時点で公開されていません。
そのため、このコスト比較は、既存の「PLaMo API」の料金を仮に当てはめた試算であり、PLaMo翻訳のAPI料金として確定したものではありません。
実際の利用費用を比較する際は、入力・出力の量、料金体系、翻訳結果の品質などをそろえて確認する必要があります。
日本語のトークン数を抑える独自トークナイザー
コストや生成速度に関わる特徴として、PFNは独自のトークナイザーを挙げています。
トークナイザーは、文章をモデルが処理する単位であるトークンに分割する仕組みです。
日本語の出力に必要なトークン数が少なくなると、トークン数に応じて費用が決まるサービスでは出力コストを抑えられる場合があります。
また、同じ時間に生成できるトークン数が一定であれば、文字数あたりの生成速度の改善にもつながる可能性があります。
ただし、実際の処理速度や料金は、利用環境やサービスの仕様にも左右されます。
高性能を支える学習データと日本語への対応
PFNは性能向上の背景として、ベースモデルの学習データに占める日本語の割合が30%近いことを挙げています。
日本語を十分に含む基盤モデルを用いることに加え、翻訳に特化した学習と、高品質なデータの活用を組み合わせています。
学習用データは集め直したうえで、LLMを使って大規模に合成したものを含むと説明されています。
翻訳では、原文の意味を維持しながら、訳文として自然な表現に整えることが重要です。
学習データの質や日本語への対応、トークナイザーの設計を一体で調整することが、PFNが掲げる品質と効率の両立につながっています。
モデルの公開と利用時に確認したいこと
モデルの重みは、前世代の「plamo-2-translate」と同様に、Hugging Faceで公開される予定です。
公開後は、利用者がモデルの仕様や提供条件を確認したうえで、自社のシステムへの組み込みや評価を検討できるようになると見込まれます。
ただし、公開時期やライセンス、商用利用の条件、必要な計算資源などの詳細は、公開情報を確認する必要があります。
翻訳サービスとして手軽に使う場合と、モデルを自分で運用する場合では、必要な準備や費用が異なります。
まとめ
「plamo-3-translate」は、PFNとNICTの共同研究で得られたモデルを基盤に、翻訳に特化して開発されたLLMです。
PFNの評価では、31Bモデルが日英・英日翻訳で高い性能を示し、8Bモデルも社内ベンチマークでTranslateGemma 27Bを上回りました。
コストについては大幅な削減が見込まれていますが、約30分の1という数値は既存のPLaMo API料金を用いた試算であり、PLaMo翻訳のAPI料金として公表されたものではありません。
PLaMo翻訳への導入に加え、モデルの重みもHugging Faceで公開予定とされており、今後は利用条件や実際の性能を確認しながら、用途に応じた評価が重要になります。