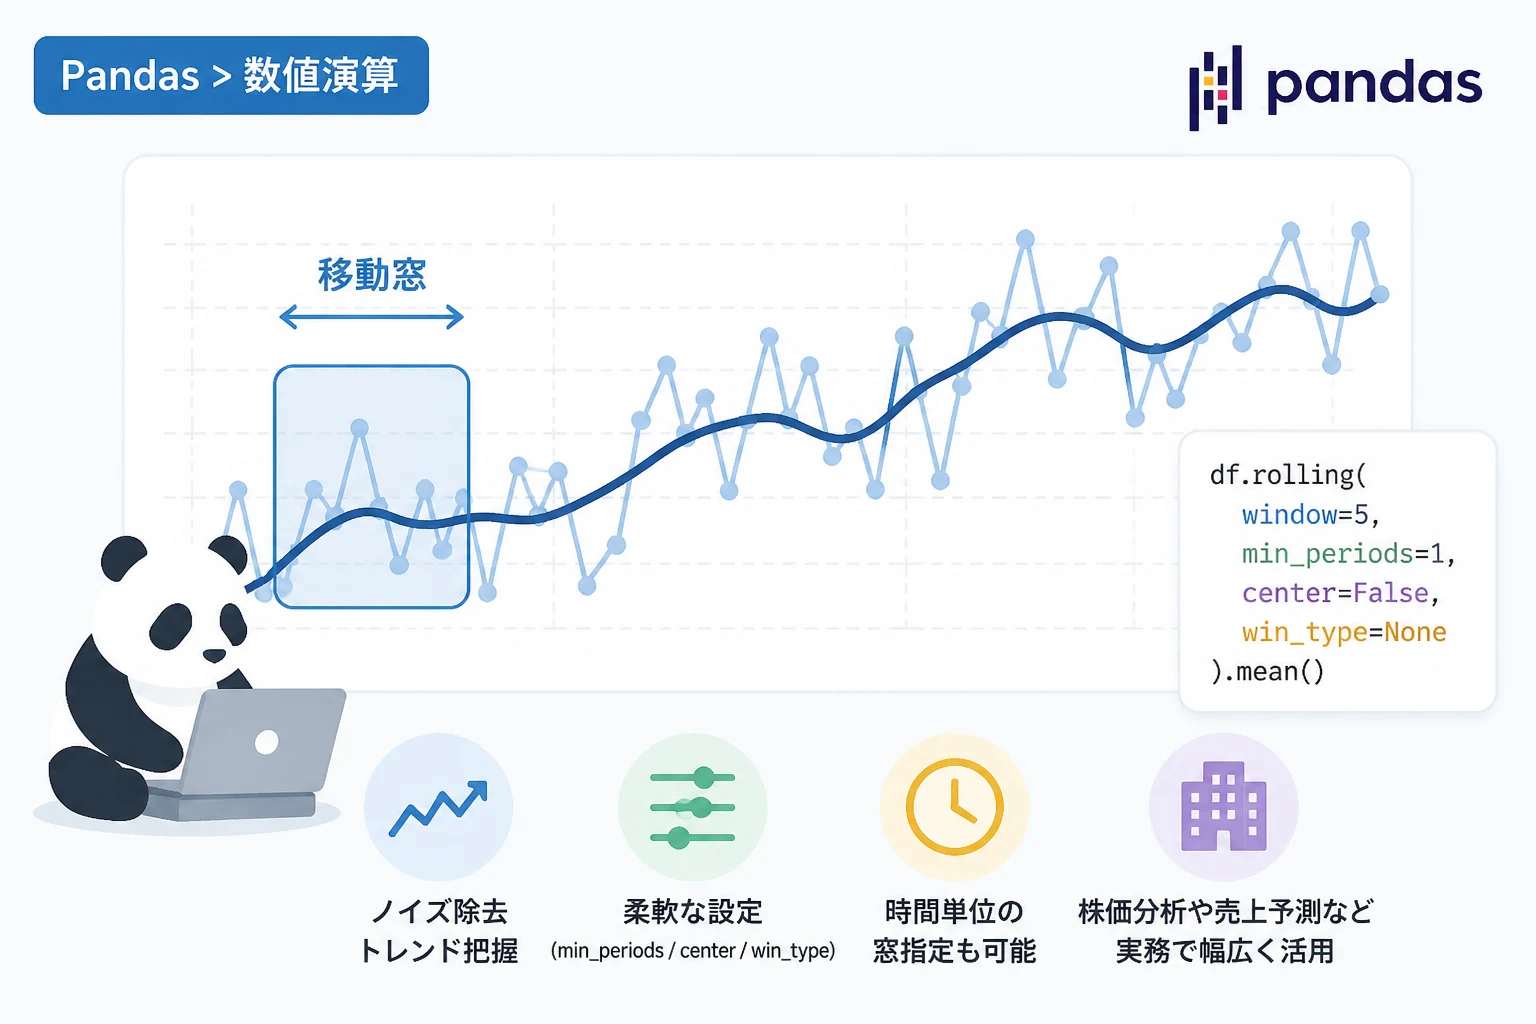
データサイエンスや金融データの分析において、時系列データのノイズを取り除き、真のトレンドを把握することは非常に重要です。
Pandasライブラリが提供するrollingメソッドは、こうした移動平均の計算を極めてシンプルかつ効率的に実行するための強力なツールです。
本記事では、Pandasを用いた移動平均の基本的な計算方法から、実務で役立つ応用テクニックまでを詳しく解説します。
初心者の方でも理解できるように、具体的なコード例とその実行結果を交えて進めていきます。
この記事を通じて、時系列データを自在に操るためのスキルを習得していきましょう。
Pandasのrollingメソッドとは
rollingメソッドは、データフレームやシリーズに対して「移動窓(ローリングウィンドウ)」を設定するための関数です。
このメソッド自体が計算を行うわけではなく、特定の範囲(窓)を定義した上で、その範囲に対して平均や合計などの統計処理を適用します。
時系列データの平滑化によく使われる手法であり、株価のテクニカル分析や売上推移の確認には欠かせません。
まずは、rollingメソッドの基本的な構文を確認しておきましょう。
import pandas as pd

# rollingメソッドの基本的な構文
# df.rolling(window=窓のサイズ).mean()このように、window引数で計算対象となるデータの個数を指定します。
続いて、計算に使用される主要なパラメータについて整理した以下の表をご覧ください。
| パラメータ | 説明 | デフォルト値 |
|---|---|---|
window | 計算対象とする窓のサイズ(整数やオフセット)を指定します。 | 必須 |
min_periods | 有効な値として計算に含める最小のデータ数を指定します。 | None(windowと同等) |
center | 窓の中心にラベルを配置するかどうかを決定します。 | False |
win_type | 窓関数の種類(ガウス分布など)を指定できます。 | None |
closed | 窓の間隔が右端、左端、あるいは両方を含むかを指定します。 | None |
これらのパラメータを適切に組み合わせることで、多様なデータ分析のニーズに対応することが可能になります。
単純移動平均(SMA)の基本操作
もっとも一般的な移動平均は、単純移動平均(Simple Moving Average: SMA)と呼ばれるものです。
これは、一定期間のデータの平均値を順番に算出していく手法です。
具体的なサンプルデータを用いて、5日間の移動平均を計算するコードを見てみましょう。
import pandas as pd
import numpy as np

# サンプルデータの作成
data = {'value': [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]}
df = pd.DataFrame(data)

# 5件のデータを用いた移動平均の計算
df['sma_5'] = df['value'].rolling(window=5).mean()

print(df) value sma_5
0 10 NaN
1 20 NaN
2 30 NaN
3 40 NaN
4 50 30.0
5 60 40.0
6 70 50.0
7 80 60.0
8 90 70.0
9 100 80.0出力結果を見ると、最初の4行がNaN(欠損値)になっていることがわかります。
これは、window=5と指定したため、計算に必要な5つのデータが揃うまで計算が行われないからです。
実務においては、この欠損値の扱いが分析精度に影響を与えることがあります。
min_periodsによる欠損値の制御
データが揃っていない段階でも、取得可能な範囲で平均を算出したい場合があります。
そのようなときには、min_periodsパラメータを使用します。
min_periodsを1に設定すると、1つでもデータがあれば計算が実行されます。
# min_periodsを指定した場合
df['sma_5_min'] = df['value'].rolling(window=5, min_periods=1).mean()

print(df[['value', 'sma_5_min']]) value sma_5_min
0 10 10.0
1 20 15.0
2 30 20.0
3 40 25.0
4 50 30.0
5 60 40.0
6 70 50.0
7 80 60.0
8 90 70.0
9 100 80.0このように、データの開始直後から数値を算出できるようになります。
分析の目的が「常に最新のトレンドを追うこと」であれば、この設定は非常に有用です。
実務的な応用:金融データと売上分析
移動平均は、実際のビジネス現場でどのように活用されているのでしょうか。
ここでは「株価のトレンド転換の検知」と「曜日変動の平滑化」という2つの事例を紹介します。
株価のゴールデンクロスとデッドクロス
投資の世界では、短期の移動平均線が長期の移動平均線を下から上に突き抜けることをゴールデンクロスと呼びます。
逆に、上から下に突き抜けることをデッドクロスと呼び、これらは売買のサインとして利用されます。
Pandasを使えば、複数の移動平均を一気に計算して比較することが容易です。
# 株価を模したデータの作成
np.random.seed(42)
prices = 100 + np.cumsum(np.random.randn(100))
df_stock = pd.DataFrame({'price': prices})

# 短期(5日)と長期(20日)の移動平均
df_stock['short_ma'] = df_stock['price'].rolling(window=5).mean()
df_stock['long_ma'] = df_stock['price'].rolling(window=20).mean()

print(df_stock.tail()) price short_ma long_ma
95 98.113289 98.181829 98.773539
96 98.411603 98.370355 98.779776
97 98.650800 98.530932 98.749007
98 98.643694 98.484989 98.730302
99 98.428456 98.449568 98.731420このように算出したデータを用いて、条件分岐(np.whereなど)を組み合わせれば、自動で売買フラグを立てるロジックも構築できます。
季節性とノイズの除去
小売業やサービス業の売上データは、土日祝日に大きく跳ね上がる傾向があります。
日次のデータそのままでは、真の成長トレンドが見えにくいことが多々あります。
こうした周期的な変動(季節性)を打ち消すには、その周期に合わせた窓サイズ(例えば7日間)で移動平均をとることが定石です。
これにより、曜日による影響が均らされ、週単位の推移が明確になります。
高度なカスタマイズ:centerとwin_type
基本的な移動平均以外にも、分析の精度を高めるためのオプションが存在します。
centerパラメータによる中心配置
通常の移動平均は「過去n日間」のデータを使用するため、算出された値は時間軸上で「後ろ」にずれる傾向があります。
後方予測ではなく、過去の履歴としてデータの中心値を捉えたい場合は、center=Trueを設定します。
# 中央に配置する移動平均
df['sma_5_centered'] = df['value'].rolling(window=5, center=True).mean()

print(df[['value', 'sma_5_centered']]) value sma_5_centered
0 10 NaN
1 20 NaN
2 30 30.0
3 40 40.0
4 50 50.0
5 60 60.0
6 70 70.0
7 80 80.0
8 90 NaN
9 100 NaNこの結果を見ると、インデックス2(30の値)の位置に、0から4までの平均値が算出されています。
時系列的なズレを解消できるため、過去データの視覚化において非常に有用なテクニックです。
win_typeによる重み付け
すべてのデータを一律に平均するのではなく、特定の分布に基づいた重み付けを行いたい場合があります。
例えば、ガウス分布(gaussian)を指定することで、窓の中心に近いデータほど重要視する計算が可能です。
複雑な信号処理や物理データの解析において、この機能は非常に強力な武器となります。
指数平滑移動平均(EMA)との違い
rollingメソッドによる単純移動平均と並んでよく使われるのが、指数平滑移動平均(Exponential Moving Average: EMA)です。
SMAは期間内のすべてのデータを平等に扱いますが、EMAは直近のデータに大きな重みを置きます。
Pandasではewm(Exponential Weighted Functions)メソッドを使用して計算します。
# 指数平滑移動平均の計算
df['ema_5'] = df['value'].ewm(span=5, adjust=False).mean()

print(df[['value', 'sma_5', 'ema_5']]) value sma_5 ema_5
0 10 NaN 10.000000
1 20 NaN 13.333333
2 30 NaN 18.888889
3 40 NaN 25.925926
4 50 30.0 33.950617
5 60 40.0 42.633745
6 70 50.0 51.755830
7 80 60.0 61.170553
8 90 70.0 70.780369
9 100 80.0 80.520246EMAはSMAに比べて価格変動への反応が早いため、トレンドの初動を捉えるのに適しています。
実務では、SMAの安定性とEMAの即応性を使い分けることが重要です。
大規模データにおけるパフォーマンスの注意点
数百万行を超えるような大規模なデータセットに対してrollingを適用する場合、計算コストに注意が必要です。
Pandasのrollingは内部的に最適化されていますが、計算対象となる列数や窓のサイズが極端に大きいとメモリを消費します。
特定の条件下では、engine='numba'パラメータを指定することで、JITコンパイルを利用した高速化が可能です。
これにより、Python標準のループよりも遥かに速いスピードで計算を完了させることができます。
# numbaエンジンを使用した高速化例(numbaのインストールが必要)
# df['value'].rolling(window=100).mean(engine='numba')
実行環境に制約がない場合は、こうした最新の最適化手法も積極的に取り入れていくと良いでしょう。
時間単位での窓指定(Time-series Offsets)
窓のサイズは、行数(整数)だけでなく、具体的な時間幅で指定することも可能です。
インデックスがDatetimeIndexである場合、「7日間(7D)」や「30日間(30D)」といった指定ができます。
これにより、データに欠損日(土日など)が含まれていても、カレンダー通りの正確な期間で平均を算出できます。
# 時間インデックスを持つデータの作成
dates = pd.date_range('2026-01-01', periods=10, freq='D')
df_time = pd.DataFrame({'value': range(10)}, index=dates)

# 3日間の期間で移動平均(行数ではなく日付ベース)
df_time['rolling_3d'] = df_time['value'].rolling(window='3D').mean()

print(df_time) value rolling_3d
2026-01-01 0 0.0
2026-01-02 1 0.5
2026-01-03 2 1.0
2026-01-04 3 2.0
2026-01-05 4 3.0
2026-01-06 5 4.0
2026-01-07 6 5.0
2026-01-08 7 6.0
2026-01-09 8 7.0
2026-01-10 9 8.0日付ベースの窓指定は、不規則な間隔で記録されるセンサーデータや、ログデータの解析において非常に強力な効果を発揮します。
まとめ
本記事では、Pandasのrollingメソッドを用いた移動平均の計算方法について網羅的に解説しました。
単純移動平均(SMA)の基本から、min_periodsやcenterといった詳細な設定、さらには指数平滑移動平均(EMA)との違いまでを理解いただけたかと思います。
移動平均は、複雑な時系列データの中に隠された「本質的な動き」をあぶり出すための第一歩です。
今回紹介した手法を組み合わせることで、より高度なデータ分析や予測モデルの構築が可能になります。
まずは身近なデータを用いて、窓サイズやパラメータの違いが結果にどう現れるかを試してみてください。
Pandasの強力な機能を使いこなし、実務における意思決定の質を高めていきましょう。