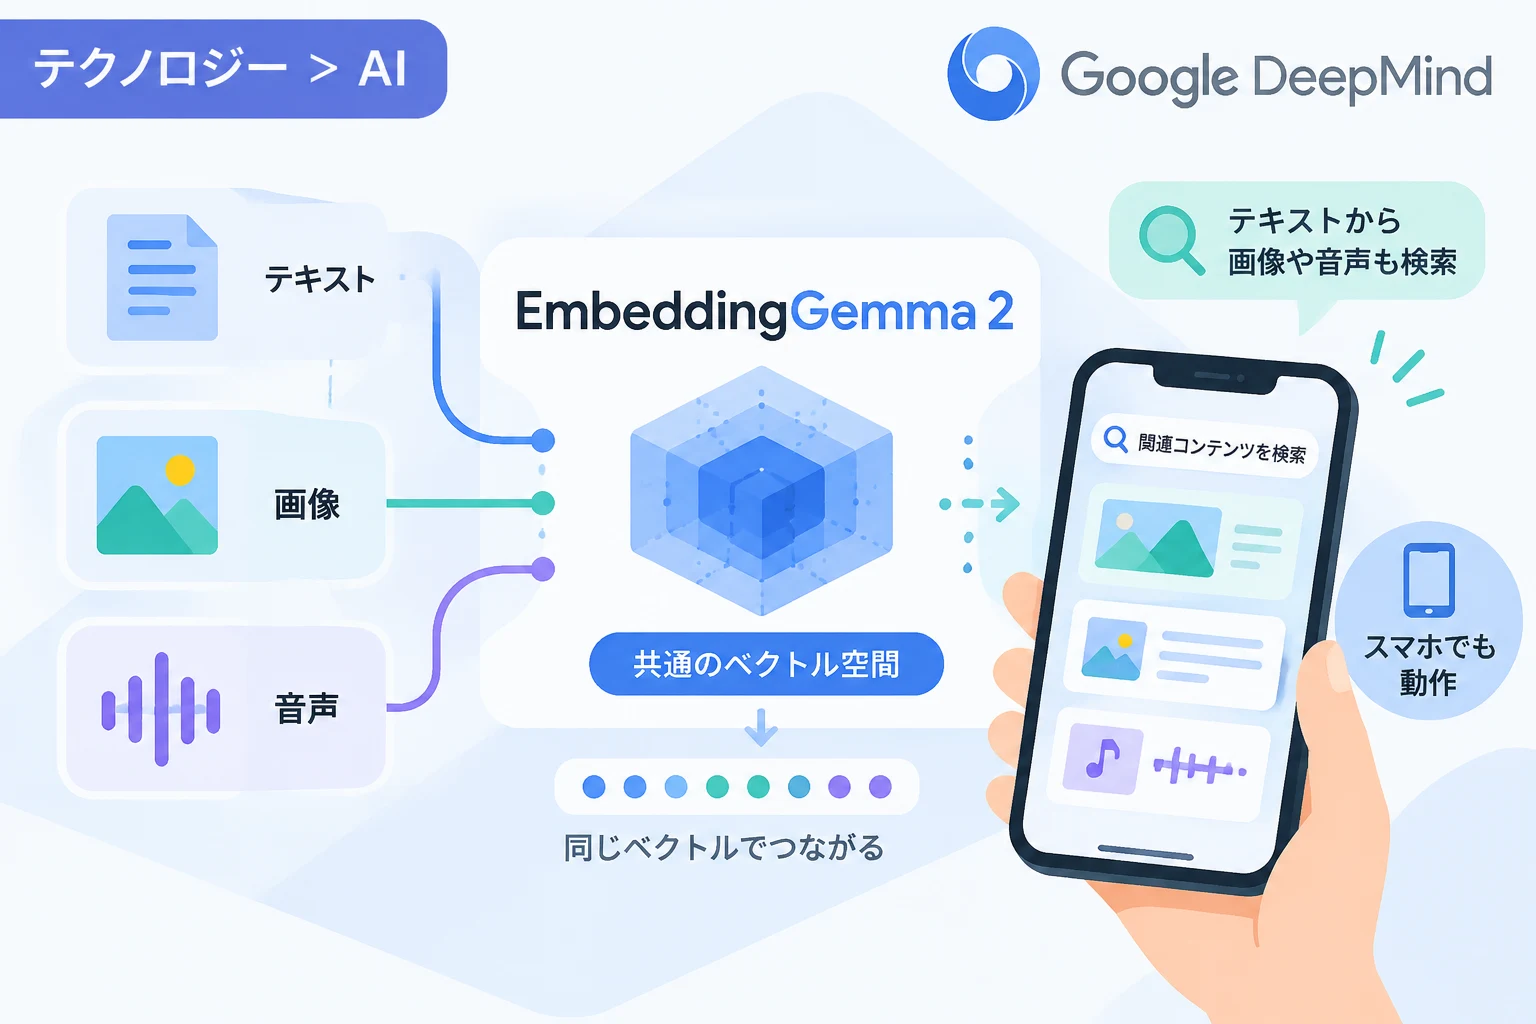
Google DeepMindは、テキストや画像、音声などを共通のベクトル空間に変換する埋め込みモデル「EmbeddingGemma 2」を公開しました。
モデル全体は7億4,000万パラメーターで、用途に応じて構成を切り替えられるほか、量子化すればスマートフォン上での動作にも対応します。
「EmbeddingGemma 2」とは
埋め込みモデルは、文章や画像などのデータを、意味や特徴を比較できる数値の列(ベクトル)へ変換するAIモデルです。
ベクトル同士の近さを調べることで、単語が完全に一致しない質問と文書を意味に基づいて結び付けられるため、検索やRAG(検索拡張生成)などに利用されています。
今回のモデルは、テキストに加えて画像や音声も扱い、それぞれを共通のベクトル空間に対応付けられる点が特徴です。
そのため、たとえば文章で入力した検索語から、関連する画像や音声のデータを探すといった、異なる種類の情報をまたぐ検索への活用が期待できます。
テキスト・画像・音声を一つのモデルで扱う
従来、動画の内容を検索するには、動画から画像を取り出してキャプションを作成したり、音声を文字起こししたりしたうえで、別のテキスト埋め込みモデルに処理させる方法が必要になる場合がありました。
EmbeddingGemma 2では、複数種類の入力を同じモデル系列でベクトル化できるため、こうした処理をまとめた検索パイプラインを構築しやすくなります。
動画については、動画全体をそのまま一つのデータとして扱うというより、音声や映像のフレームを入力し、内容を検索可能な形にする使い方が想定されます。
複数のモデルを連携させる構成と比べて、システムの設計や実装を簡略化しやすく、モデル間のデータ受け渡しに伴うレイテンシやメモリ使用量の削減も見込めます。
用途に合わせてモデルの構成を調整
EmbeddingGemma 2は、すべての入力形式を常に使うのではなく、必要なエンコーダーを追加するモジュール構成を採用しています。
| 構成要素 | パラメーター数 | 主な用途 |
|---|---|---|
| テキストモデル | 約2億7,000万 | 文章やコードの埋め込み |
| 画像エンコーダー | 約1億7,000万 | 画像を含む検索 |
| 音声エンコーダー | 約3億 | 音声を含む検索 |
| 全モジュール合計 | 約7億4,000万 | 複数形式を組み合わせた処理 |
テキスト検索が中心のサービスであれば、テキストモデルだけを利用することで、モデル全体を使う場合より計算資源を抑えられます。
画像や音声を扱う機能が必要になった段階で対応するエンコーダーを加えられるため、用途に応じた構成を選びやすい設計です。
また、Googleの「Gemma 4」とテキストのトークナイザーおよび音声エンコーダーを共有しており、両モデルを組み合わせたオンデバイス処理では、構成によってメモリ使用量を抑えられるとしています。
ベクトルのサイズを調整し、保存容量を削減
EmbeddingGemma 2は、出力するベクトルの次元数を768から512、256、128へ短縮できる「Matryoshka Representation Learning(MRL)」に対応します。
ベクトルの次元数を小さくすると、検索用データの保存容量や検索時に扱うデータ量を減らせるため、大量の文書や画像を管理する用途で効果があります。
公表資料では、設定によってベクトルのデータ量を最大6分の1に削減できるとされています。
ただし、次元数を減らすと検索精度が低下する場合があり、特に128次元は主にテキスト用途に適するとされています。
本番環境に導入する際は、容量だけで決めず、実際の検索データと評価指標を使って精度を確認することが重要です。
スマートフォンでの利用と処理上の目安
EmbeddingGemma 2は、量子化によってモデルの容量を抑え、スマートフォンなどの端末上で動作させることを想定しています。
Googleによると、「Google Pixel 11 Pro」ではテキストモデルの重みに必要なアクティブRAMは約191MBで、マルチモーダルモデル全体では約567MBです。
端末内で処理できれば、データをクラウドに送信せずに検索を行える可能性があり、通信環境に左右されにくい設計やプライバシーを重視する用途にも役立ちます。
ただし、実際のメモリ消費量や応答速度は、量子化の設定、入力の長さ、端末の性能、同時に動かすアプリなどによって変わります。
最大8Kトークンのコンテキスト
コンテキストウィンドウは8Kトークンで、先代の「EmbeddingGemma」の4倍に拡大しました。
標準設定では、音声は最大約5.5分、画像は約29枚、動画は約58フレームをローカルで処理できるとされています。
これらを組み合わせる場合は、それぞれの入力が共通の8Kトークン枠を消費するため、すべての上限を同時に利用できるわけではありません。
長い動画や大量の画像を扱う場合は、フレームの抽出間隔や入力単位を調整し、検索に必要な情報を効率よくモデルへ渡す工夫が必要です。
性能・ライセンス・利用方法
Googleは、EmbeddingGemma 2が「MTEB」のコード関連評価や「MAEB」などで、10億パラメーター未満のマルチモーダル埋め込みモデルとして高い水準のスコアを記録したと説明しています。
コード埋め込み性能を大きく改善しながら、多言語テキスト性能は先代と同等を維持したとしていますが、評価結果はベンチマークやデータセットに基づくため、個々の用途での精度を保証するものではありません。
ライセンスは商用利用も可能なApache 2.0で、モデルはHugging FaceとKaggleで公開されています。
「Ollama」や「LM Studio」などにも対応し、Androidでは「ML Kit」から利用できるようになる予定です。
MediaPipeの「Decision Task API」と組み合わせれば、学習データやファインチューニングなしで、入力を分類ラベルと照合して振り分ける用途にも利用できます。
まとめ
EmbeddingGemma 2は、テキスト、画像、音声を共通のベクトル空間で扱い、検索やRAGのための処理をまとめやすくするマルチモーダル埋め込みモデルです。
テキストだけなら約2億7,000万パラメーターで利用でき、量子化やベクトル次元の調整によって、端末の性能や保存容量に応じた運用を検討できます。
導入時は、8Kトークンの入力上限や次元数による精度の変化を踏まえ、対象データを使った評価を行うことが大切です。