Pythonの数値計算ライブラリであるNumPyには、配列を生成するための便利な関数が数多く用意されています。
データ分析や機械学習のモデル構築において、特定の数値で埋められた配列を準備する機会は非常に多いものです。
例えば、初期値としてすべて「-1」や「NaN(欠損値)」、あるいは特定の定数を保持する多次元配列が必要になるシーンが挙げられます。
このような場合に最適なのが、今回解説するnp.full関数です。
本記事では、np.fullの基本的な書き方から、実務で役立つデータ型の指定方法、他の初期化関数との違いまで詳しく紹介します。
np.full関数の基本的な役割
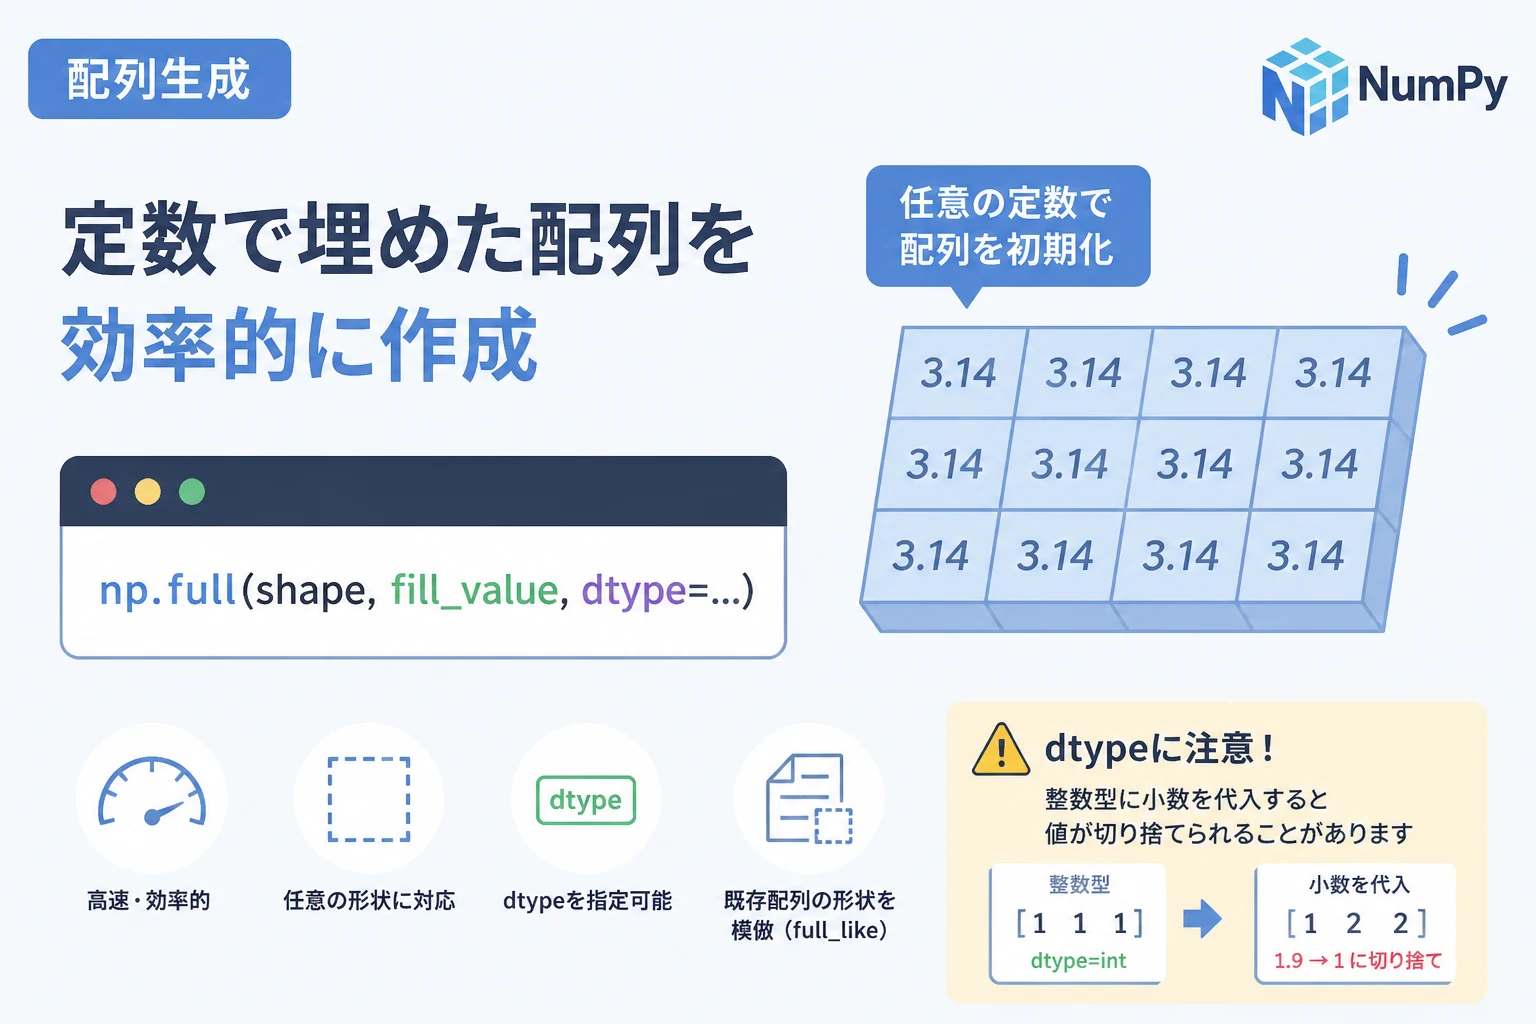
np.fullは、指定した形状(シェイプ)の配列を生成し、そのすべての要素を任意の定数で埋めるための関数です。
NumPyには「0」で埋めるnp.zerosや「1」で埋めるnp.onesが存在しますが、np.fullはそれらよりも柔軟性が高いという特徴があります。
整数の「10」や浮動小数点数の「0.5」、さらには「np.nan」といった特殊な値まで、自由な値を初期値として設定できるのが最大のメリットです。
np.fullの構文と引数
まずは、np.fullの基本的な構文を確認しておきましょう。
numpy.full(shape, fill_value, dtype=None, order='C', *, like=None)この関数で使用頻度が高い主要な引数について、以下の表にまとめました。
| 引数名 | 説明 |
|---|---|
| shape | 作成する配列の形状を整数またはタプルで指定します(例:3, (2, 3))。 |
| fill_value | 配列の各要素を埋めるための定数を指定します。 |
| dtype | 配列のデータ型を指定します。省略した場合はfill_valueから推論されます。 |
| order | メモリ上の配置順序を指定します(’C’なら行優先、’F’なら列優先)。 |
基本的には、第一引数のshapeと第二引数のfill_valueさえ理解しておけば十分に活用可能です。
基本的な使い方:定数配列の作成
それでは、具体的なコードを用いて配列を作成してみましょう。
まずは、1次元配列に特定の値を埋める例を紹介します。
import numpy as np

# 5つの要素すべてを「7」で埋めた1次元配列を作成
arr_1d = np.full(5, 7)

print(arr_1d)[7 7 7 7 7]このように、第一引数に要素数、第二引数に値を指定するだけで簡単に作成できます。
次に、2次元配列(行列)を作成する場合を見てみましょう。
# 2行3列の配列を「3.14」で埋めて作成
arr_2d = np.full((2, 3), 3.14)

print(arr_2d)[[3.14 3.14 3.14]
[3.14 3.14 3.14]]多次元配列の場合は、形状をタプル (行, 列) で渡す必要がある点に注意してください。
データ型(dtype)の指定と注意点
np.fullを使用する際、データ型の扱いには少し注意が必要です。
明示的にdtypeを指定しない場合、NumPyはfill_valueに渡された値に基づいて自動的にデータ型を決定します。
デフォルトの型推論
例えば、整数を渡せばint型になり、浮動小数点数を渡せばfloat型になります。
# 整数の「10」を渡す
res_int = np.full(3, 10)
print(f"値: {res_int}, 型: {res_int.dtype}")

# 浮動小数点数の「10.0」を渡す
res_float = np.full(3, 10.0)
print(f"値: {res_float}, 型: {res_float.dtype}")値: [10 10 10], 型: int64
値: [10. 10. 10.], 型: float64このように、入力値の種類によって配列の性質が変わります。
明示的な型指定の重要性
プログラムの堅牢性を高めるためには、dtypeを明示的に指定することをおすすめします。
例えば、整数の「0」で初期化しつつも、後から小数を代入する可能性がある場合は、最初からfloat型として定義しておくべきです。
# 整数を渡すが、型をfloatに指定する
arr_float_fixed = np.full((2, 2), 0, dtype=float)

print(arr_float_fixed)
print(arr_float_fixed.dtype)[[0. 0.]
[0. 0.]]
float64もしint型で作成された配列に後から小数を代入しようとすると、小数点以下が切り捨てられるなどの意図しない挙動を招く恐れがあります。
特殊な値で配列を埋める方法
実務においては、単なる数値以外で配列を初期化したい場面が多々あります。
欠損値(NaN)で埋める
データセットのプレースホルダとして、すべてをNaN(Not a Number)で埋めた配列を作りたい場合があります。
この場合、np.nanをfill_valueに指定します。
# NaNで埋めた3x3の配列を作成
nan_array = np.full((3, 3), np.nan)

print(nan_array)[[nan nan nan]
[nan nan nan]
[nan nan nan]]なお、NaNは浮動小数点数として定義されているため、この配列のdtypeは自動的にfloat64となります。
無限大(Inf)で埋める
アルゴリズムの実装(例:最短経路問題のコスト初期値など)で、すべてを無限大で初期化したい場合もnp.fullが便利です。
# 無限大で埋める
inf_array = np.full((2, 2), np.inf)

print(inf_array)[[inf inf]
[inf inf]]他の初期化関数との比較
NumPyには他にも配列を生成する関数があります。
それぞれの用途を理解し、適切に使い分けることがコードの可読性向上につながります。
| 関数名 | 主な用途 | 備考 |
|---|---|---|
np.zeros | すべて「0」で埋める | 最も高速に動作する場合が多い |
np.ones | すべて「1」で埋める | フラグ管理やマスク処理の初期値に便利 |
np.full | 任意の定数で埋める | 0や1以外で初期化したい場合に最適 |
np.empty | 未初期化の配列を作成 | 値はメモリ上のゴミが入るが、最速 |
例えば、np.full(shape, 0)と書くよりも、np.zeros(shape)と書くほうが「0で埋める」という意図が他の開発者に伝わりやすくなります。
逆に、「すべてを100で埋める」といった意図があるなら、100 * np.ones(shape)とするよりも、np.full(shape, 100)とするほうが直接的で計算効率も良いです。
既存の配列と同じ形状で作る「np.full_like」
すでにある配列と同じ形状、同じデータ型で新しい定数配列を作りたい場合には、np.full_likeが非常に便利です。
これを使えば、わざわざ元の配列のshapeを取得してnp.fullに渡す手間が省けます。
base_arr = np.array([[1, 2, 3], [4, 5, 6]])

# base_arrと同じ形状・型で「-1」埋めの配列を作成
new_arr = np.full_like(base_arr, -1)

print(new_arr)[[-1 -1 -1]
[-1 -1 -1]]画像処理のフィルタリングや、既存データのマスクを作成する際によく利用される手法です。
この際、dtypeを別途指定しなければ、元の配列のデータ型が引き継がれる点に留意してください。
パフォーマンスに関する考察
大規模なデータを扱う場合、初期化のスピードが気になることもあるでしょう。
一般的に、np.zerosやnp.onesは内部的に最適化されており、非常に高速です。
np.fullも十分高速ですが、内部的には指定した値を各メモリ領域にコピーする処理が発生します。
とはいえ、実務レベルのサイズ(数百万要素程度)であれば、実行時間の差を意識する必要はほとんどありません。
むしろ、「どのような値で初期化したか」をソースコード上で明確に示すことの方が重要です。
まとめ
NumPyのnp.fullは、任意の定数で配列を初期化するための非常に柔軟で強力な関数です。
任意の数値はもちろん、NaNやInfといった特殊な値での初期化も簡単に行うことができます。
利用する際は、shapeをタプルで指定すること、そして必要に応じてdtypeを明示することを忘れないようにしましょう。
また、既存の配列を活用する場合にはnp.full_likeを使用することで、よりシンプルにコードを記述できます。
これらの関数を使いこなすことで、Pythonによるデータ処理の効率をさらに高めていくことができるはずです。
今回学んだ内容を、日々のスクリプト作成やデータ分析の現場でぜひ活用してみてください。