Pythonでデータサイエンスや機械学習に取り組む際、PandasとNumPyの連携は避けて通れない重要なステップです。
特に、PandasのDataFrameやSeriesに格納されたデータを、数値計算ライブラリであるNumPyの配列(ndarray)に変換したい場面は多々あります。
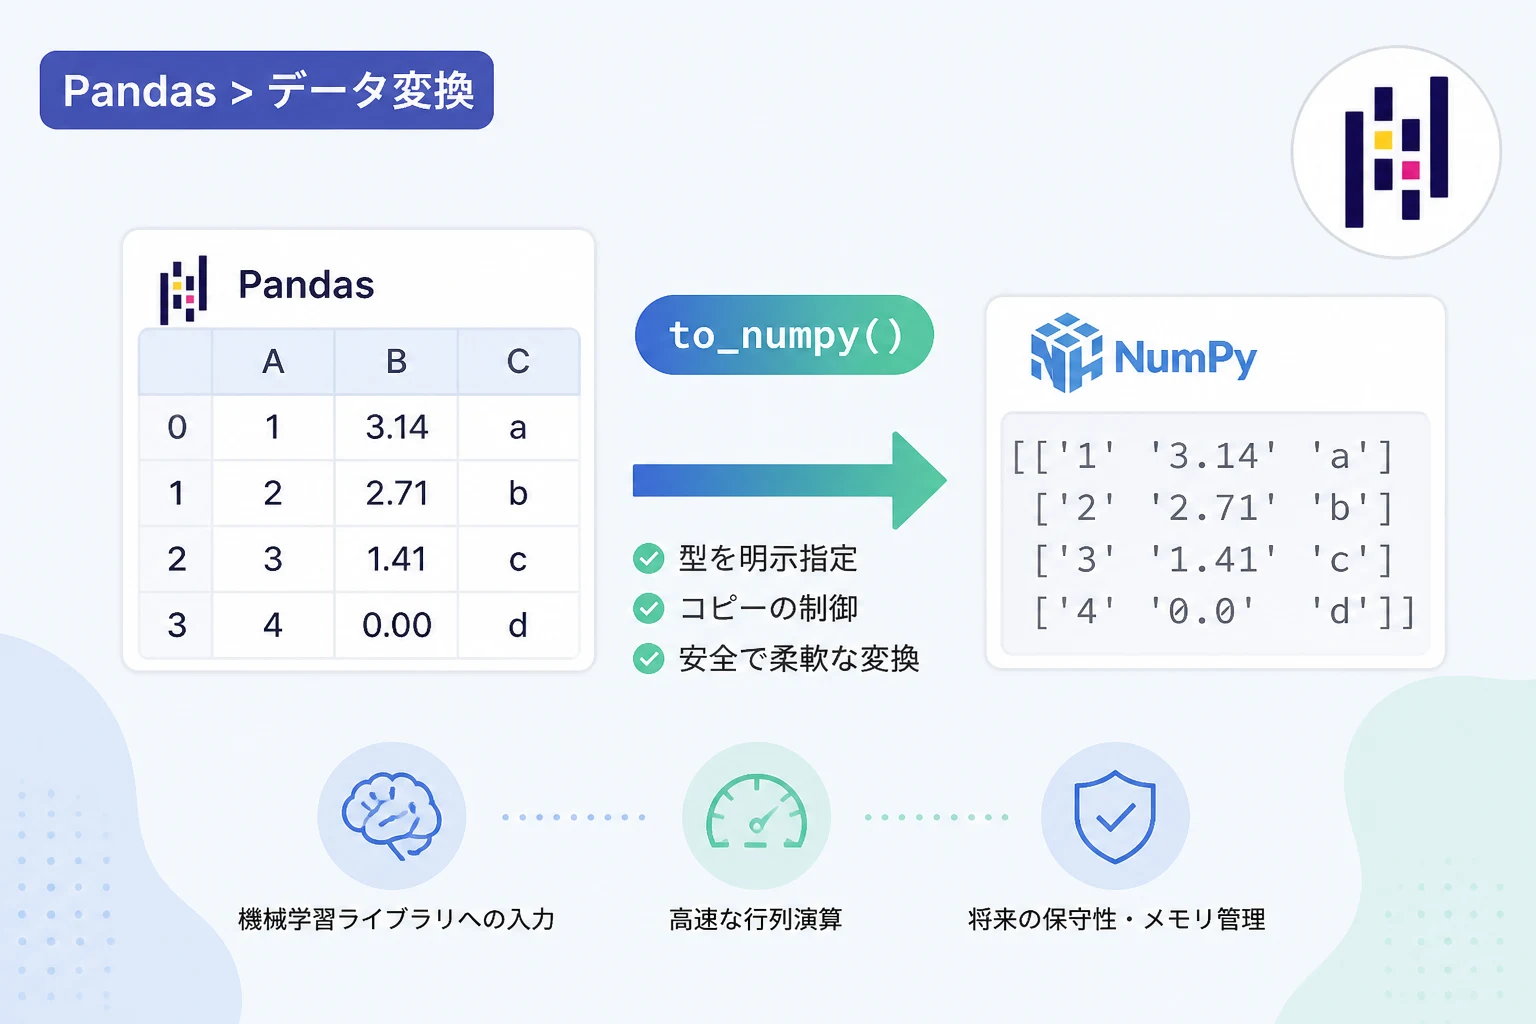
かつてはvalues属性を使用するのが一般的でしたが、現在のモダンなPython開発環境ではto_numpy()メソッドの使用が推奨されています。
本記事では、2026年現在の最新仕様に基づき、これら2つの変換手法の違いや使い分け、そして実務で役立つ具体的な実装パターンを詳しく解説します。
PandasからNumPy配列へ変換する理由
データ分析の現場において、なぜPandasからNumPyへデータを変換する必要があるのでしょうか。
第一の理由は、多くの機械学習ライブラリがNumPyのndarray形式を標準の入力フォーマットとしている点にあります。
例えば、Scikit-learnやPyTorch、TensorFlowといったライブラリでは、モデルの学習や推論を行う際にNumPy配列を渡すことが一般的です。
第二に、NumPyは高度に最適化されたC言語やFortranのバックエンドを利用しており、行列演算などの数値計算においてPandasよりも高速な処理が期待できる場合があります。
Pandasはデータの整理やクリーニングに長けていますが、純粋な数学的演算を大量に行うフェーズではNumPyに軍配が上がることが少なくありません。
また、メモリ効率の観点からも、Pandas独自のメタデータを排した純粋な数値配列としてデータを扱う方が有利なケースがあります。
こうした背景から、データ前処理をPandasで行い、計算フェーズでNumPyへ変換するという流れが標準的なワークフローとなっています。
values属性による基本的な変換方法
まずは、古くから使われているvalues属性について見ていきましょう。
values属性は、Pandasオブジェクトが内部で保持しているデータをNumPy配列として返すプロパティです。
以下のコード例では、DataFrameとSeriesからそれぞれデータを取得する方法を示します。
import pandas as pd
import numpy as np

# サンプルデータの作成
df = pd.DataFrame({
    'A': [1, 2, 3],
    'B': [4.5, 5.5, 6.5],
    'C': ['x', 'y', 'z']
})

# values属性を使用してndarrayに変換
array_from_df = df.values
array_from_series = df['A'].values

print("DataFrameからの変換結果:\n", array_from_df)
print("Seriesからの変換結果:", array_from_series)
print("データ型:", type(array_from_df))DataFrameからの変換結果:
[[1 4.5 'x']
[2 5.5 'y']
[3 6.5 'z']]
Seriesからの変換結果: [1 2 3]
データ型: <class 'numpy.ndarray'>実行結果から分かる通り、values属性を呼び出すだけで簡単にNumPyのndarrayを取得することが可能です。
しかし、この手法にはいくつかの注意点が存在します。
DataFrameに異なるデータ型(int、float、objectなど)が混在している場合、NumPy配列はそれらをすべて保持できる共通の型(通常はobject型)に変換されます。
これにより、本来数値として処理したかったデータがオブジェクトとして扱われ、計算速度が低下するリスクがあります。
推奨されるto_numpy()メソッドの使い方
Pandas 0.24.0以降、values属性の代わりとしてto_numpy()メソッドが導入されました。
2026年現在の開発現場では、意図しない挙動を防ぐためにこのメソッドの使用が強く推奨されています。
to_numpy()が優れている点は、変換時のデータ型(dtype)やコピーの有無を引数で明示的に指定できることです。
# to_numpy()を使用した変換
# データ型を指定して変換することが可能
array_float = df[['A', 'B']].to_numpy(dtype='float64')

print("float64に変換された配列:\n", array_float)
print("配列のデータ型:", array_float.dtype)float64に変換された配列:
[[1. 4.5]
[2. 5.5]
[3. 6.5]]
配列のデータ型: float64このように、特定の列だけを抽出して数値型に統一して変換するといった操作が、メソッド一つで完結します。
また、copy=Trueを指定することで、元のPandasオブジェクトとのメモリ共有を解除し、独立した配列として安全に扱うことができます。
valuesとto_numpy()の決定的な違い
なぜvaluesではなくto_numpy()を使うべきなのか、その理由をさらに深掘りしてみましょう。
最も大きな違いは、「拡張配列(Extension Arrays)」への対応です。
近年のPandasでは、欠損値を含む整数型(Int64)やカテゴリ型、タイムゾーン付きの時刻型など、NumPy標準にはない独自のデータ型が多用されています。
values属性を使用した場合、これらの拡張配列がどのNumPy型に変換されるかが不透明であり、バージョンによって挙動が異なる場合がありました。
一方、to_numpy()はこれらの変換ロジックを整理し、ユーザーが予測可能な形で動作するように設計されています。
データ型の整合性と欠損値の扱い
NumPyは本来、欠損値(NaN)を浮動小数点数(float)として扱います。
しかし、Pandasの新しい整数型で欠損値を保持している場合、valuesでは予期せぬオブジェクト型配列が返されることがあります。
to_numpy()を使用し、引数でna_value(一部の環境やバージョンで拡張される機能)や明示的なdtypeを指定することで、こうした混乱を避けることができます。
メモリのコピーとビューの関係
パフォーマンスを重視する場合、変換が「コピー(新しいメモリ確保)」なのか「ビュー(元の参照)」なのかを意識する必要があります。
values属性は、可能な限りメモリをコピーせずに参照を返そうとしますが、型変換が必要な場合は強制的にコピーが発生します。
対して、to_numpy()はcopy引数を持つため、開発者が明示的に挙動を制御できるというメリットがあります。
意図しないメモリの書き換えを防ぎたい場合は、常にcopy=Trueを意識すると良いでしょう。
【実践】ケース別の変換テクニック
実際の開発でよく遭遇するシチュエーション別の変換方法を整理しました。
特定の列のみをNumPy配列にする
DataFrame全体ではなく、特定の列のみをターゲットにすることは非常に多い操作です。
# 特定の複数列を選択して変換
target_columns = ['A', 'B']
X = df[target_columns].to_numpy()

print("選択された列の配列:\n", X)選択された列の配列:
[[1. 4.5]
[2. 5.5]
[3. 6.5]]Seriesをベクトルとして変換する
Seriesを変換する場合、1次元の配列として取得されます。
# Seriesの変換
y = df['A'].to_numpy()
print("1次元配列:", y.shape)1次元配列: (3,)機械学習のライブラリによっては、(n_samples, 1)のような2次元形状を求められることがあります。
その場合は、NumPyのreshapeを組み合わせるか、DataFrame形式で抽出してから変換するのがスムーズです。
パフォーマンス比較と2026年時点の最適解
大量のデータを扱う際、変換速度はアプリケーションの応答性に直結します。
結論から述べると、単純な変換においてvaluesとto_numpy()の実行速度に劇的な差はありません。
しかし、近年のPandasがバックエンドにPyArrowを採用するケースが増えている点に注目すべきです。
PyArrowベースのDataFrameをNumPyに変換する場合、メモリレイアウトの再配置が発生するため、従来のNumPyネイティブなデータよりもコストがかかる場合があります。
このような最新の内部構造を考慮しても、インターフェースが統一されているto_numpy()を利用することが、将来的なコードの保守性を高める唯一の選択肢と言えます。
よくあるエラーとトラブルシューティング
変換時に初心者が陥りやすいミスとその対策をまとめました。
| 事象 | 原因 | 対策 |
|---|---|---|
| 配列がobject型になる | 列の中に文字列やNoneが混在している | 変換前にastype()で型を揃えるか、to_numpy(dtype=’float’)を指定する |
| 値が書き換わる | ビューとして取得した配列を操作している | to_numpy(copy=True)を使用して独立させる |
| AttributeError | 非常に古いPandasを使用している | Pandasを最新バージョンにアップデートする |
特にobject型への意図しない変換は、後の数値計算でエラーを引き起こす最大の要因です。
変換後には必ず.dtypeプロパティを確認する習慣をつけましょう。
まとめ
本記事では、PandasからNumPy配列への変換方法について、values属性とto_numpy()メソッドの違いを中心に解説しました。
values属性は手軽に利用できますが、データ型の制御や将来の互換性を考えると、現在では推奨されません。
これからの開発では、明示的にdtypeやcopyを指定できるto_numpy()メソッドを標準として活用しましょう。
特に、欠損値を含むデータや多種多様なデータ型が混在するプロジェクトにおいて、この使い分けがコードの信頼性を大きく左右します。
2026年以降のモダンなデータ分析スタックにおいても、この基礎知識はあらゆるライブラリとの橋渡しとして役立ち続けるはずです。
まずはご自身のコードの中で.valuesを使っている箇所を.to_numpy()に置き換えることから始めてみてはいかがでしょうか。