Pythonを用いてWebスクレイピングを行う際、多くの開発者が最初に直面する大きな壁が、意図しないHTTPエラーへの対応です。
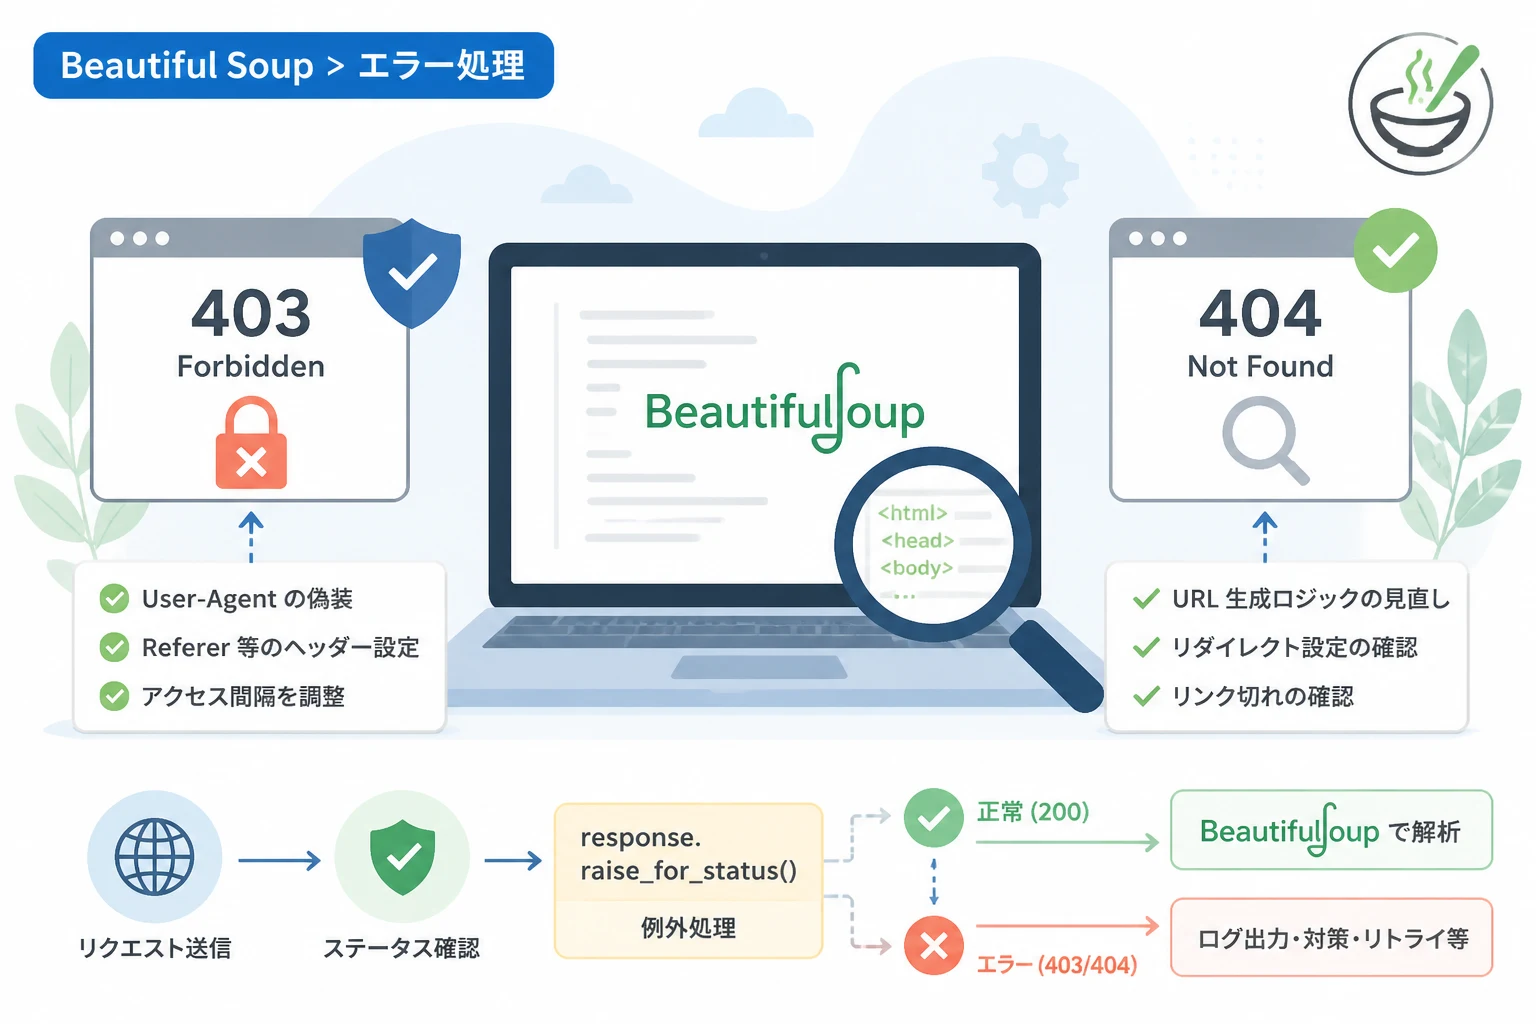
特に、情報の取得を試みた際に返される「403 Forbidden」や「404 Not Found」は、プログラムの実行を停止させる主要な要因となります。
これらのエラーが発生する背景には、サーバー側のセキュリティ設定や、リクエストの不備など、さまざまな理由が隠されています。
本記事では、PythonのrequestsライブラリとBeautiful Soupを組み合わせて使用する際に、これらのエラーをどのように回避し、適切に処理すべきかを詳しく解説します。
スクレイピングで遭遇する403エラーと404エラーの正体
HTTPステータスコードは、Webサーバーがクライアントからのリクエストに対して返す応答の状態を示すものです。
スクレイピングにおいて最も頻繁に遭遇するエラーの一つが、「403 Forbidden(閲覧権限がありません)」です。
これは、サーバーがリクエストを理解したものの、何らかの理由でその実行を拒否したことを示しています。
多くの場合、サーバー側のセキュリティ対策によって、プログラムによる自動アクセスが検知・遮断されていることが原因です。
一方、「404 Not Found(未検出)」は、指定したURLに該当するリソースが見つからない場合に返されます。
単なるURLの記述ミスであることも多いですが、スクレイピングにおいては、動的に生成されるURLのパターンが変更されていたり、ページが既に削除されていたりする場合に発生します。
403 Forbiddenエラーが発生する主な原因と回避策
403エラーが発生する最大の理由は、サーバーが「人間によるブラウザ操作」と「プログラムによる機械的なアクセス」を区別していることにあります。
デフォルト設定のrequestsライブラリを使用してアクセスすると、サーバー側にはPythonスクリプトからのアクセスであることが容易に判別されてしまいます。
User-Agent(ユーザーエージェント)の設定
サーバーは、リクエストヘッダーに含まれるUser-Agentの情報を確認して、アクセス元の環境を判断しています。
requestsのデフォルトのUser-Agentは「python-requests/2.x.x」のようになっており、これが拒否の対象となることが非常に多いです。
この問題を解決するには、ブラウザと同じUser-Agentをヘッダーに設定する必要があります。
import requests

url = "https://example.com"
# ブラウザのUser-Agentを模倣する
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

response = requests.get(url, headers=headers)
print(response.status_code)200リクエストヘッダーの充実化
User-Agent以外にも、サーバーがチェックしているヘッダー情報は複数存在します。
例えば、Referer(どのページから遷移してきたか)やAccept-Language(言語設定)などが挙げられます。
これらを適切に設定することで、より「人間らしい」リクエストを偽装することが可能になります。
特に複雑な認証やボット対策が導入されているサイトでは、これらの情報の有無が成否を分ける重要なポイントとなります。
404 Not Foundエラーへの対処法とURLの確認
404エラーは、リクエスト自体は受理されているものの、対象が見つからないという状態です。
まずは、プログラム内で生成しているURLが正しい形式であるかを再確認する必要があります。
動的なURL生成のミスを疑う
ページネーションや検索結果をループ処理で取得する場合、URLの末尾に数値を結合することがよくあります。
しかし、サイトの仕様変更により、ページ番号の指定方法が「page=1」から「p=1」に変わるようなケースは珍しくありません。
また、URLに含まれる日本語などのマルチバイト文字が、正しくパーセントエンコーディングされていない場合も404の原因となります。
リダイレクトの追跡設定
requestsライブラリはデフォルトでリダイレクトを自動的に追跡しますが、複雑な遷移が行われる際に正しく処理されないことがあります。
allow_redirects=Trueの設定を確認し、必要に応じて遷移の履歴(response.history)を調査することが推奨されます。
requestsにおける適切なエラーハンドリングの実装
スクレイピングを安定して運用するためには、エラーが発生した際にプログラムを異常終了させず、適切に処理するコードが必要です。
requestsには、レスポンスがエラー(4xx系や5xx系)であった場合に例外を発生させるraise_for_status()メソッドが用意されています。
try-exceptを用いた堅牢なコード
以下のコード例は、エラー発生時に詳細な内容を出力し、プログラムの停止を防ぐための基本的なパターンです。
import requests
from requests.exceptions import HTTPError

url = "https://example.com/api/data"

try:
    response = requests.get(url, timeout=10)
    # ステータスコードが200以外の場合に例外を発生させる
    response.raise_for_status()

    # 正常な場合の処理
    print("データの取得に成功しました。")

except HTTPError as http_err:
    if response.status_code == 403:
        print(f"403エラー:アクセスが拒否されました。ヘッダー設定を確認してください。")
    elif response.status_code == 404:
        print(f"404エラー:ページが見つかりません。URLを確認してください。")
    else:
        print(f"HTTPエラーが発生しました: {http_err}")
except Exception as err:
    print(f"その他のエラーが発生しました: {err}")
Beautiful Soupと連携させる際の注意点
エラーが発生しているにもかかわらずBeautiful Soupで解析を進めてしまうと、思わぬ不具合を招きます。
たとえば、403エラーが返されている場合でも、サーバーは「アクセス拒否」を伝えるためのHTMLを返していることがあります。
この「エラー画面のHTML」をBeautiful Soupで解析すると、期待していた要素が見つからず、プログラムがAttributeErrorなどで停止してしまいます。
ステータスコードを判定してからパースする
「レスポンスが正常であることを確認した後にのみ解析を実行する」というフローを徹底してください。
from bs4 import BeautifulSoup
import requests

url = "https://example.com/items"

response = requests.get(url)

if response.status_code == 200:
    # 正常な場合のみBeautiful Soupに渡す
    soup = BeautifulSoup(response.content, "html.parser")
    title = soup.find("h1").get_text()
    print(f"タイトル: {title}")
else:
    # エラー時の処理
    print(f"ステータスコード {response.status_code} のため、解析をスキップしました。")
スクレイピングエラーを回避するための高度な手法
単純なヘッダー設定だけでは403エラーを回避できない場合、さらに高度な対策が必要になります。
Sessionオブジェクトの活用
requests.Session()を使用すると、Cookie情報や設定したヘッダーを複数のリクエスト間で保持することができます。
ログインが必要なサイトや、同一セッション内での遷移をチェックしているサイトでは、このSessionオブジェクトの利用が必須となります。
リトライ(再試行)処理の実装
一時的なネットワークの不安定さや、サーバー側の一時的な制限によって403が発生することもあります。
このような場合には、数秒の待機時間を設けてから再度リクエストを行う「リトライ処理」が有効です。
urllib3のRetryクラスをrequestsに組み込むことで、自動的に再試行を行う設定が可能です。
| エラーコード | 主な原因 | 代表的な対処法 |
|---|---|---|
| 403 Forbidden | ボット検知、IP制限、権限不足 | User-Agentの設定、セッションの維持、プロキシの使用 |
| 404 Not Found | URLミス、リンク切れ、動的URLの変更 | URLの生成ロジック確認、リダイレクト追跡 |
| 429 Too Many Requests | 短時間の過剰アクセス | アクセス間隔(sleep)の延長、リトライ処理 |
アクセス制限(BAN)を防ぐためのエチケット
技術的な解決策を講じる前に、忘れてはならないのが対象サーバーへの負荷に対する配慮です。
短時間に大量のリクエストを送信することは、サーバーに過度な負荷をかけるだけでなく、DDoS攻撃とみなされて恒久的なIPブロック(BAN)を受けるリスクを高めます。
必ずtime.sleep()を挿入し、少なくとも1秒以上の間隔を空けてアクセスするように心がけましょう。
また、robots.txtを確認し、スクレイピングが禁止されているディレクトリへのアクセスは控えるのがWeb業界の基本的なマナーです。
まとめ
PythonのrequestsとBeautiful Soupを用いたスクレイピングにおいて、403エラーや404エラーは避けては通れない課題です。
403エラーに対しては、User-Agentを始めとするヘッダー情報を適切に設定し、必要に応じてSessionオブジェクトを活用することが有効な対策となります。
一方、404エラーに対しては、プログラム内のURL生成ロジックを精査し、リダイレクトの挙動を追跡することが解決への近道です。
いずれの場合も、raise_for_status()やtry-exceptを用いた適切なエラーハンドリングを実装することで、予期せぬ停止に強い安定したシステムを構築できます。
技術的な工夫とサーバーへの礼儀を両立させながら、効率的なデータ収集を行いましょう。