PythonでWebスクレイピングを行う際、最も頻繁に利用されるライブラリの一つがBeautifulSoupです。
HTML構造の中から特定の情報を抽出するためには、タグ名を正確に指定して要素を取得するスキルが欠かせません。
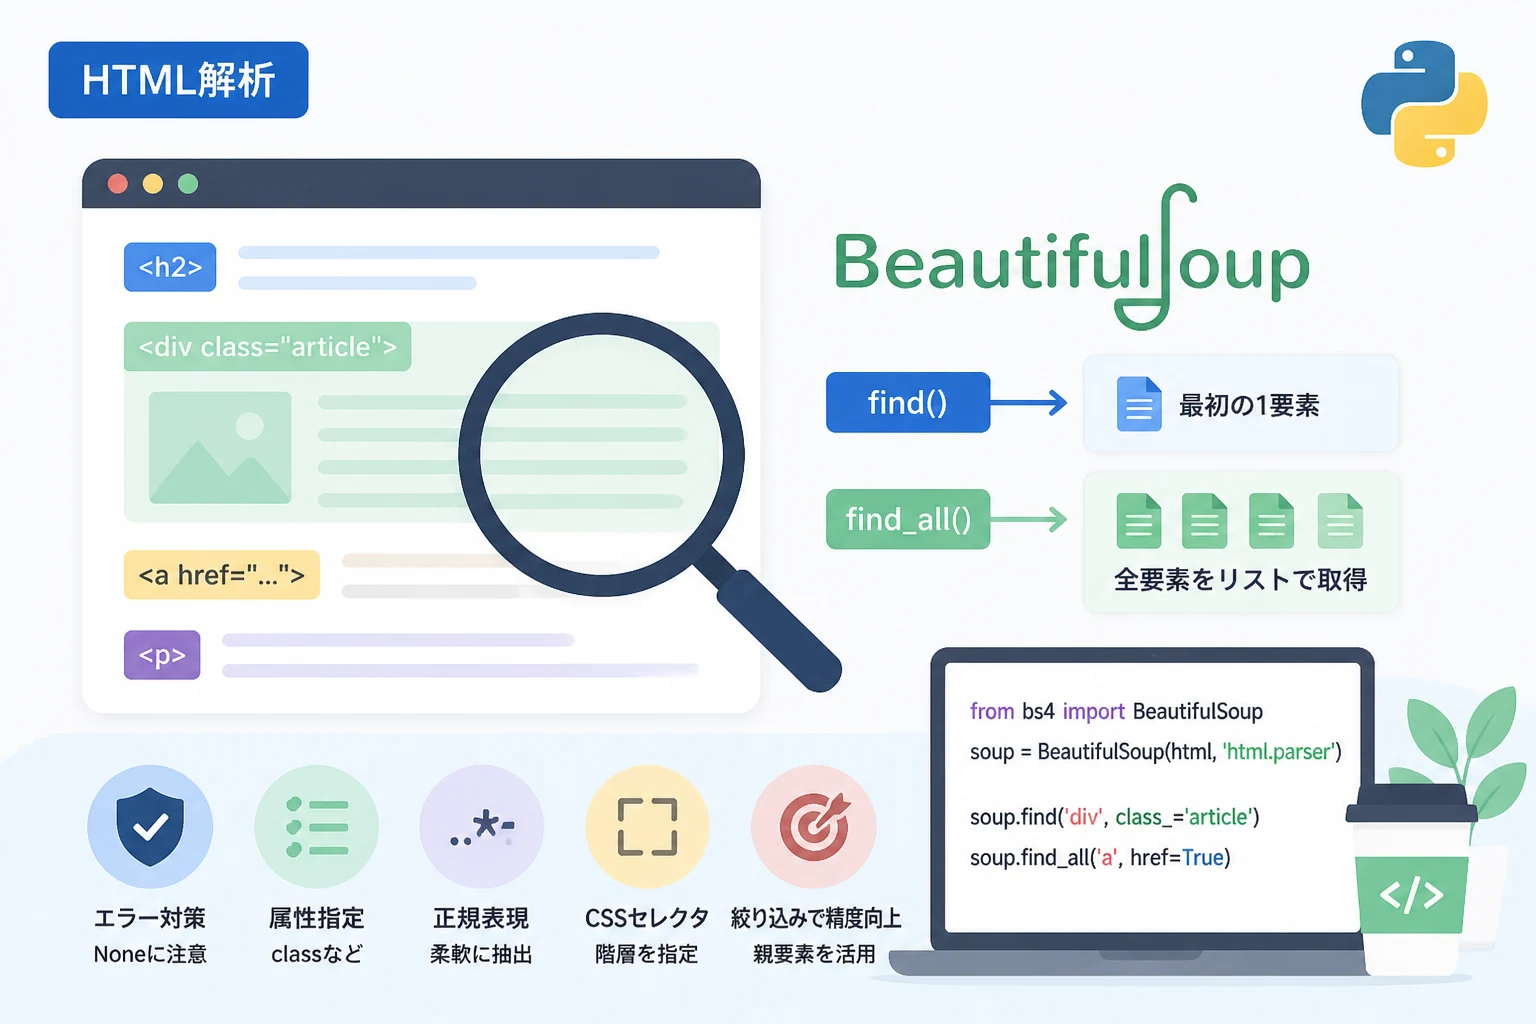
BeautifulSoupには、要素を取得するための主要なメソッドとして、伝統的なfindメソッドと、CSSセレクタを利用するselectメソッドの2種類が存在します。
本記事では、これらのメソッドをどのように使い分けるべきか、具体的なコード例を交えて詳しく解説していきます。
効率的なデータ収集を実現するために、タグ名指定の基本から応用テクニックまでをマスターしましょう。
BeautifulSoupにおけるタグ指定の基本
BeautifulSoupは、解析したHTMLをツリー構造として保持し、直感的な操作で特定のタグにアクセスすることを可能にします。
まずは、ライブラリのインポートとHTMLのパース(解析)の基本手順を確認しておきましょう。
from bs4 import BeautifulSoup

# サンプルHTML
html_doc = """
<html>
<head><title>テックブログ</title></head>
<body>
    <h1>Pythonスクレイピング入門</h1>
    <p class="description">BeautifulSoupの使い方を学びましょう。</p>
    <div id="content">
        <ul>
            <li class="item">タグ名の指定方法</li>
            <li class="item">属性でのフィルタリング</li>
            <li class="item">CSSセレクタの活用</li>
        </ul>
    </div>
</body>
</html>
"""

# BeautifulSoupオブジェクトの作成
soup = BeautifulSoup(html_doc, 'html.parser')
準備が整ったら、目的のタグを取得する具体的な方法を見ていきます。
BeautifulSoupで最も基本的な取得方法は、オブジェクトに対して直接タグ名を指定することです。
例えば、soup.h1と記述するだけで、HTML内の最初の<h1>タグを取得できます。
# タグ名による直接アクセス
print(soup.h1)<h1>Pythonスクレイピング入門</h1>ただし、この方法は「最初に見つかった要素」のみを返すため、複雑なHTML構造では不十分な場合があります。
そこで、より柔軟な検索を可能にするのがfindやselectといったメソッドです。
findメソッドとfind_allメソッドによるタグ指定
BeautifulSoupの伝統的な手法であるfind系メソッドは、引数にタグ名を渡すことで要素を検索します。
直感的で分かりやすく、特定の条件に合致する要素をピンポイントで探すのに適しています。
findメソッドで単一の要素を取得する
findメソッドは、条件に一致する最初の要素を1つだけ返します。
もし該当するタグが見つからない場合は、Noneを返却します。
# findを使ってh1タグを取得
title_tag = soup.find('h1')
print(title_tag.text)Pythonスクレイピング入門findの強力な点は、タグ名だけでなく、属性情報と組み合わせて検索できることです。
find_allメソッドで全ての要素を取得する
同一のタグ名を持つ要素が複数存在する場合、find_allメソッドを使用します。
このメソッドは、条件に一致する全ての要素をリスト形式で返します。
# find_allを使ってすべてのliタグを取得
items = soup.find_all('li')

for item in items:
print(f"項目: {item.text}")項目: タグ名の指定方法
項目: 属性でのフィルタリング
項目: CSSセレクタの活用実務では、ニュース記事の見出し一覧や商品リストを取得する際に多用されます。
属性を指定して絞り込む
同じタグ名が多数ある場合、クラス名やIDを指定してターゲットを絞り込む必要があります。
findやfind_allでは、第二引数以降にキーワード引数を渡すことでフィルタリングが可能です。
# class属性を指定して取得(classは予約語のためclass_とする)
description = soup.find('p', class_='description')
print(description.text)

# id属性を指定して取得
content_div = soup.find('div', id='content')
print(content_div.ul.li.text)
Pythonの予約語である「class」と衝突を避けるため、class属性の指定には「class_」というアンダースコア付きの名称を使う点に注意しましょう。
selectメソッドとselect_oneメソッド(CSSセレクタ)
モダンなスクレイピング手法として推奨されるのが、selectメソッドです。
これは、Web開発者がスタイルシート(CSS)を適用する際に使用するCSSセレクタをそのまま利用できる方法です。
select_oneで単一要素を取得
select_oneは、CSSセレクタに一致する最初の要素を返します。
findと同じ役割を果たしますが、より複雑な階層構造を簡潔に記述できます。
# CSSセレクタでh1を取得
h1_tag = soup.select_one('h1')

# 階層を指定して取得(divの中にあるulの中にある最初のli)
first_item = soup.select_one('div#content > ul > li')
print(first_item.text)
selectで全要素をリスト取得
selectメソッドは、セレクタに合致する全ての要素をリストで返します。
複数のクラスを持つ要素や、特定の親子関係にある要素を抽出する際に非常に強力です。
# クラス名がitemの全ての要素を取得
items = soup.select('.item')

for item in items:
    print(item.get_text())
CSSセレクタに慣れているフロントエンドエンジニアにとっては、こちらの記法の方が圧倒的に扱いやすいでしょう。
findとselectの使い分け:どちらを使うべきか?
BeautifulSoupを使用する際、どちらのメソッドを使うべきか迷うことがあります。
結論から言えば、「単純なタグ指定ならfind、複雑な条件ならselect」という使い分けが一般的です。
それぞれのメリットとデメリットを比較してみましょう。
| 機能 | find / find_all | select / select_one |
|---|---|---|
| 記法 | Pythonの引数形式 | CSSセレクタ形式 |
| 可読性 | 単一条件なら高い | 複雑な階層指定に強い |
| 柔軟性 | 正規表現や関数が使いやすい | 複雑な親子関係の記述が容易 |
| 学習コスト | BeautifulSoup独自仕様を学ぶ | CSSの知識があれば即戦力 |
findのメリット:Pythonicな記述
findメソッドの利点は、Pythonの辞書やキーワード引数として属性を渡せる点にあります。
例えば、属性値に変数を使いたい場合や、正規表現を適用したい場合にはfindの方が柔軟です。
import re

# タグ名に正規表現を使う例(h1, h2, h3...をすべて取得)
headers = soup.find_all(re.compile('^h[1-6]'))
selectのメリット:圧倒的な記述の短縮
一方で、selectは複数の条件(タグ名 + ID + クラス)を一括で指定できるため、コードが非常に短くなります。
例えば、「idがmainのdivの中にある、classがactiveのliタグ」を取得する場合、findでは多重にネストさせる必要がありますが、selectなら1行で済みます。
# findの場合(冗長になりやすい)
target = soup.find('div', id='main').find('li', class_='active')

# selectの場合(スッキリ記述できる)
target = soup.select_one('div#main li.active')
メンテナンス性を重視し、直感的にパスを理解したい場合はCSSセレクタを利用するのが現代的な選択です。
実践的なタグ名指定のテクニック
基本を押さえたところで、実務で役立つ応用的なテクニックを紹介します。
複数のタグ名を一度に検索する
特定のタグを複数種類同時に取得したい場合があります。
find_allにリストを渡すことで、複数のタグをまとめて抽出できます。
# h1とpをまとめて取得
elements = soup.find_all(['h1', 'p'])
for el in elements:
    print(f"{el.name}: {el.text}")
テキストの内容で要素を検索する
タグ名だけでなく、表示されているテキストの内容に基づいて要素を特定することも可能です。
string引数(古いバージョンではtext)を使用します。
# 「タグ名の指定方法」というテキストを含むli要素を探す
target_item = soup.find('li', string='タグ名の指定方法')
print(target_item)
親要素や兄弟要素へのアクセス
目的の要素にIDやクラスが設定されていない場合、近くの「目印」となるタグを見つけ、そこから相対的に移動します。
parent、find_next_sibling、find_previous_siblingなどのメソッドを活用しましょう。
# 特定の要素の次の要素(兄弟)を取得
first_li = soup.find('li', class_='item')
second_li = first_li.find_next_sibling('li')
print(second_li.text)
このように、DOMツリーを上下左右に移動することで、構造が複雑なサイトでも確実に目的のデータへ到達できます。
エラーを防ぐための注意点
スクレイピング実行時に最も多いエラーが、要素が見つからなかった場合のAttributeErrorです。
findやselect_oneは要素がない場合にNoneを返すため、その後に.textなどを呼び出すとエラーが発生します。
存在チェックを行う
要素を取得した後は、必ず存在を確認する条件分岐を入れるのがプロの作法です。
target = soup.find('span', class_='price')

if target:
    print(target.text)
else:
    print("要素が見つかりませんでした。")
大規模なスクレイピングを行う場合、一部のページだけ構造が異なっていることは珍しくありません。
プログラムを停止させないためにも、適切なエラーハンドリングを心がけましょう。
パーサーの選択による挙動の違い
BeautifulSoupのコンストラクタに渡す「パーサー(解析器)」によって、タグの解釈が微妙に異なる場合があります。
一般的には、標準のhtml.parserよりも、高速で寛容なlxmlを使用することが推奨されます。
# lxmlをインストール済みの場合
soup = BeautifulSoup(html_doc, 'lxml')lxmlは壊れたHTML(閉じタグがないなど)に対しても強力に補完を行ってくれるため、実世界のWebサイトを扱う際に有利です。
まとめ
本記事では、PythonのBeautifulSoupを用いてタグ名を指定し、要素を取得する様々な方法を解説しました。
findメソッドはシンプルかつ柔軟な属性指定が可能であり、Pythonらしいコードを書くのに適しています。
一方でselectメソッドは、CSSセレクタの強力な表現力を活用して、複雑な階層構造を効率的に記述できるメリットがあります。
どちらか一方だけを覚えるのではなく、状況に応じて両者を使い分けることが、スキルの高い開発者への第一歩です。
まずは今回紹介したコード例を参考に、実際にWebサイトのHTML構造を解析し、データの抽出に挑戦してみてください。
正確なタグ名指定をマスターすることで、あなたのスクレイピングの精度と効率は飛躍的に向上するはずです。